改变世界的100个产品经理·第28位:梁文锋
如果要在过去两年全球科技界选出一个最不像传统科技明星的掌舵人,梁文锋一定是那个最极致的样本。
他极少在公开峰会上发表宏篇大论的煽情演讲,几乎从不接受泛娱乐媒体的商业包装专访,在互联网上甚至很难搜到几张高清的标准商务西装照。
但就是这样一位常年隐居幕后的量化交易掌门人,在 2024 至 2025 年间,用接连几篇沉甸甸的技术白皮书和几个开源权重包,让大洋彼岸的硅谷巨头们经历了一场前所未有的漫长失眠:
当 OpenAI 的奥特曼还在游说中东主权基金筹集 7 万亿美元建设晶圆厂时,他带着几十位中国年轻工程师,用不到 600 万美元的训练成本,做出了性能比肩甚至在数学与代码上反超前者的顶尖推理模型;
当国内外主流厂商还在按每百万 Token 收取几十元甚至上百元的高昂 API 费用时,他反手把价格降到了一两毛钱,直接将全球大模型暴利模式击穿,逼得整个行业掀起了断崖式的价格雪崩。
他让全球科技界第一次意识到:在最前沿的人工智能核心深水区,中国人不仅能跟跑,更能用第一性原理的极限工程,重写全球技术的成本法则。
算力黑客:从量化顶级猎手到深度求索
很多人把 DeepSeek 的爆发归结为某种不可思议的运气,但如果回看梁文锋过去十五年的底层底色,你会发现这是一场蓄谋已久的硬核技术长征。
从浙江大学电子信息工程系毕业后,梁文锋没有选择传统互联网大厂的业务红海,而是一头扎进了对算力、算法与系统吞吐量要求最为苛刻的量化交易领域。
他创办的幻方量化,在极其残酷的高频金融博弈中脱颖而出,跻身中国顶级百亿量化私募之列。
而在所有金融机构还在租用通用云服务器跑模型时,幻方做了一个让整个金融圈侧目的极客决定:自建万卡超算中心「萤火一号」与「萤火二号」。
在绝大多数同行还在把 AI 当作金融回测工具时,梁文锋早在 2021 年就已经深刻洞察到了算力 Scaling Law 的威力。当 2023 年 ChatGPT 引爆全球生成式 AI 浪潮、无数创业者蜂拥去搞套壳应用和泛娱乐聊天时,梁文锋决定成立独立研发机构——深度求索(DeepSeek)。
他的目标极其纯粹、极其朴素,甚至带着一种与时代喧嚣格格不入的理想主义:探索通往通用人工智能(AGI)的最短路径,并且完全开源。
架构降维打击:用第一性原理刺穿暴利泡沫
在 DeepSeek 出现之前,硅谷的大模型研发遵循着一种近乎粗暴的「美式暴力美学」:算力不够就买卡,模型不灵就加参数,动辄数万张顶级 H100 GPU 连片狂轰,把整个 AI 工业演变成了只有万亿美元市值巨头才能玩得起的烧钱游戏。
而梁文锋和他的团队,展现出了一种完全不同的中国工程师哲学——向数学要效率,向架构要空间。
第一,MLA(多头潜在注意力机制)。 大模型推理最大的瓶颈是显存中的 KV Cache 膨胀。随着上下文拉长,显存被大量中间状态撑爆,导致并发极低、成本奇高。DeepSeek 创新性地提出了低秩联合压缩投影,将 KV Cache 压缩了整整 90% 以上。这一架构创新使得单张显卡能够承载的并发量暴增数倍,直接在物理层面把推理成本砸到了地表。
第二,超细粒度 MoE(专家混合架构)。 当同行还在用 8 个粗粒度专家网络时,DeepSeek-V2/V3 将网络切分成了 64 个甚至上百个精细专家,配合无辅助损失的负载均衡算法。每次激活只唤醒最相关的几十亿参数,用小模型的推理开销跑出了千亿参数的智能上限。
第三,FP8 混合精度底层突破。 在业内普遍认为 8 位浮点数训练极其容易梯度爆炸的共识下,DeepSeek 从通信算子底层重写 CUDA 核心,实现了全流程稳定的 FP8 混合精度训练,将显卡显存占用和算力通信开销再次砍半。
2024 年 5 月,DeepSeek-V2 发布,每百万 Token 仅售 1 元人民币(输入仅需 0.14 元)。
随后,阿里、腾讯、百度、字节跳动全线宣布大模型大幅降价,国内大模型彻底告别了「贵族玩具」时代,真正变成了任何一个普通开发者和中小企业都用得起的水电煤。
R1 的地震:纯强化学习颠覆闭源神话
如果说 2024 年的 DeepSeek-V3 证明了中国团队拥有极致的工程优化能力,那么 2025 年初发布的 DeepSeek-R1,则彻底完成了一次从工程跟跑到科学开创的惊天逆袭。
在以往,大模型的复杂推理能力高度依赖昂贵的人工标注(SFT,监督微调)。OpenAI 靠着数以千计的专业数据标注团队打磨出 o1 模型,并将其视为最高核心机密,死死闭源封锁。
而梁文锋带领团队展示了前所未有的科研自信:
他们证明了纯通过大规模强化学习(RL),在完全不使用人类标注数据的前提下,大模型自己就能自发涌现出回溯、自我反思、长思维链演化等高阶推理行为。
更让全世界科技界肃然起敬的是,DeepSeek 毫无保留地向全球公开了完整的技术报告,详细阐述了冷启动、多阶段训练、知识蒸馏的所有关键坑点,并把权重完全免费开源。
发布当周,全球开源社区几乎陷入狂欢,Hugging Face 上 R1 的衍生模型数千个如雨后春笋般涌现,甚至一度引发了美股芯片巨头英伟达的市值单日剧烈震荡。
纳德拉在公开演讲中坦言:「DeepSeek 的工程创新令人惊叹。」扎克伯格更是直接将其列为 Meta Llama 团队必须严肃研究的核心对手。
梁文锋用最纯粹的技术实力,撕开了被硅谷闭源巨头垄断的人工智能铁幕。
改变世界的六维评分拆解
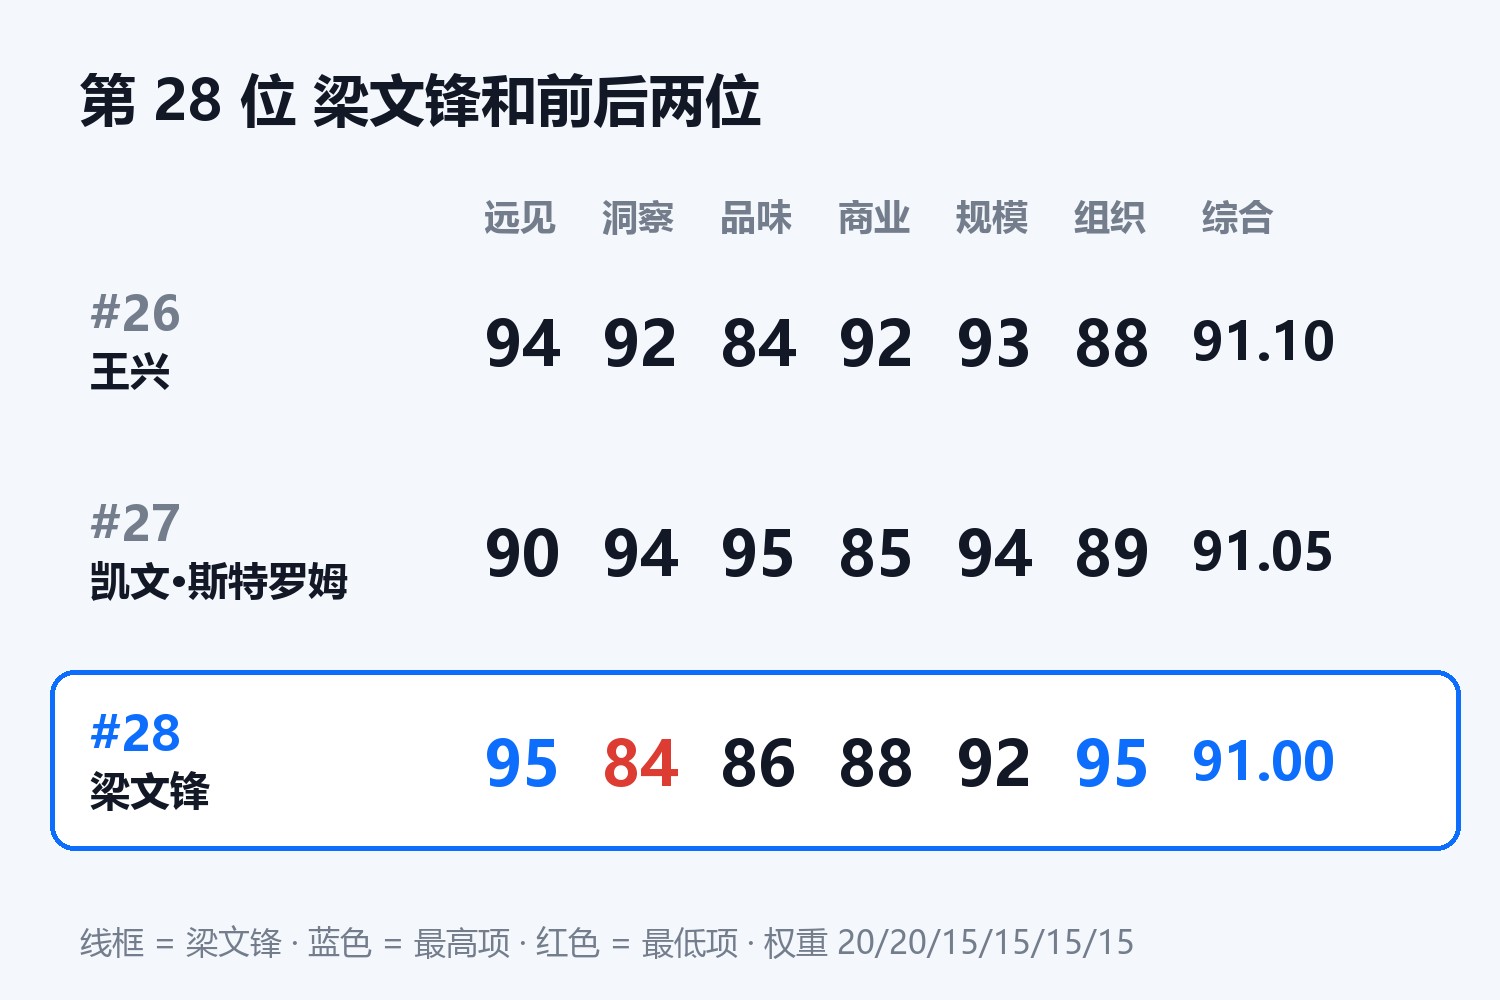
在《改变世界的 100 个产品经理》评分体系中,梁文锋综合评分 91.00,名列全榜第 28 位,稳居「传奇档」阵营。六维雷达具体拆解如下:
1. 远见(Vision):95 分
在所有人还在把量化当作短线套利机器时,他看准了底层算力与分布式超算的终局;在大模型百模大战陷入套壳商业化噱头时,他耐得住寂寞直击基础模型底座;在行业迷信算力堆砌时,他坚定选择 MoE、低比特训练与强化学习新范式。他用极少的声音,做出了极早、极准的战略预判。
2. 组织(Organization / Execution):95 分
顶格的工程密度与黑客文化。没有繁复的大公司官僚汇报,没有层层叠叠的 KPI 评审,核心研发团队不过几十人,却能爆发出压倒千人集团军的敏捷推进力。这是中国硬核科技企业在组织工程力上的一个全新标杆。
3. 规模(Scale):92 分
作为原生开源模型,其权重与蒸馏版本渗透到了全球数以千万计的开发者终端、云服务商与学术机构中。从硅谷顶级 AI 实验室到中国普通大学生的笔记本电脑,DeepSeek 成为了仅次于 Meta Llama 的全球开源第一梯队核心力量。
4. 商业(Business):88 分
极致的低价重塑了全球算力经济学,让开源生态拥有了对抗垄断巨头的底气。 扣分点(12 分)在于:DeepSeek 目前坚持极致普惠的 API 定价与开源策略,短期内自身的直接商业化杠杆和盈利诉求极度克制,研发更多依赖量化母体的资本输血。它对全球商业格局的改变是「破坏性重塑」,而非为自身谋取垄断超额利润。
5. 品味(Taste):86 分
六维相对偏低项。DeepSeek 的官方网站、交互界面以及移动端 App 长期保持着极为质朴的“工程师极简风”:一个纯蓝的鲸鱼 Logo、一个简单的对话输入框。没有华丽的情绪化动效,没有精致的生活方式包装。对于习惯了精致设计的普通消费者而言,它更像是一把冷峻精准的手术刀,而非一件赏心悦目的工艺品。
6. 洞察(Insight):84 分(六维最低分)
梁文锋的长项在于对物理法则、数学逻辑与算力吞吐的第一性原理洞察,但他并不以捕捉人类细腻微观的心理需求见长。 与乔布斯、张小龙这类能够通过产品细节引发亿万人情感共鸣的天才不同,他的产品直接诉诸于逻辑、代码与答案本身。在理解 C 端大众的情感孤独、社交虚荣与非理性偏好等更深层的人性领域,这并非他的发力重心,也是其评分中最为诚实的短板所在。
结语
在商业狂飙的时代,很多人习惯于用融资额度、发布会声量和估值泡沫来衡量一个领袖。
但梁文锋提供了一种更为坚固的范本:
他像一个沉默的数字手艺人,把全部精力投注在代码、算子和损失函数的收敛上。他用事实击碎了“大模型只有靠美国巨额资本才能做出来”的偏见,也为中国年轻一代的技术创业者树立了一个纯粹、自信且极具尊严的标杆。
改变世界的产品经理,不仅有定义人机交互的艺术家,更有用代码拆解世界深层规则的筑基者。梁文锋当得起这个时代对硬核工程师最高的敬意。
讨论