全球大模型最新调用量周榜出炉:中国开源模型拿走前十里的6席,编程调用暴涨3倍
大模型行业的风向,在过去半年里发生了一场静悄悄却极其彻底的逆转。
一年前,如果你打开全球开发者最常用的模型路由聚合平台 OpenRouter,排在调用量前十名的清一色全是美国硅谷闭源巨头的天下——OpenAI 的 GPT 系列、Anthropic 的 Claude 系列以及 Google 的 Gemini 几乎垄断了九成以上的流量。
然而,最新出炉的全球周度调用量真实账单,给所有只看发布会宣传的人浇了一盆冷水:在全球单周高达 28 万亿 Token 的真实付费与生产调用中,调用量排名前十的主力模型席位里,来自中国的开源模型(DeepSeek 系列与阿里通义 Qwen 系列)已经拿走了整整 6 席!
跑分榜单可以靠题库微调「刷」出来,但全世界几十万家创业公司和独立开发者每天刷信用卡付出去的 API 账单,绝对不会撒谎。
一、 真实调用量三分天下:Claude 守高端,DeepSeek 与千问吃下基本盘
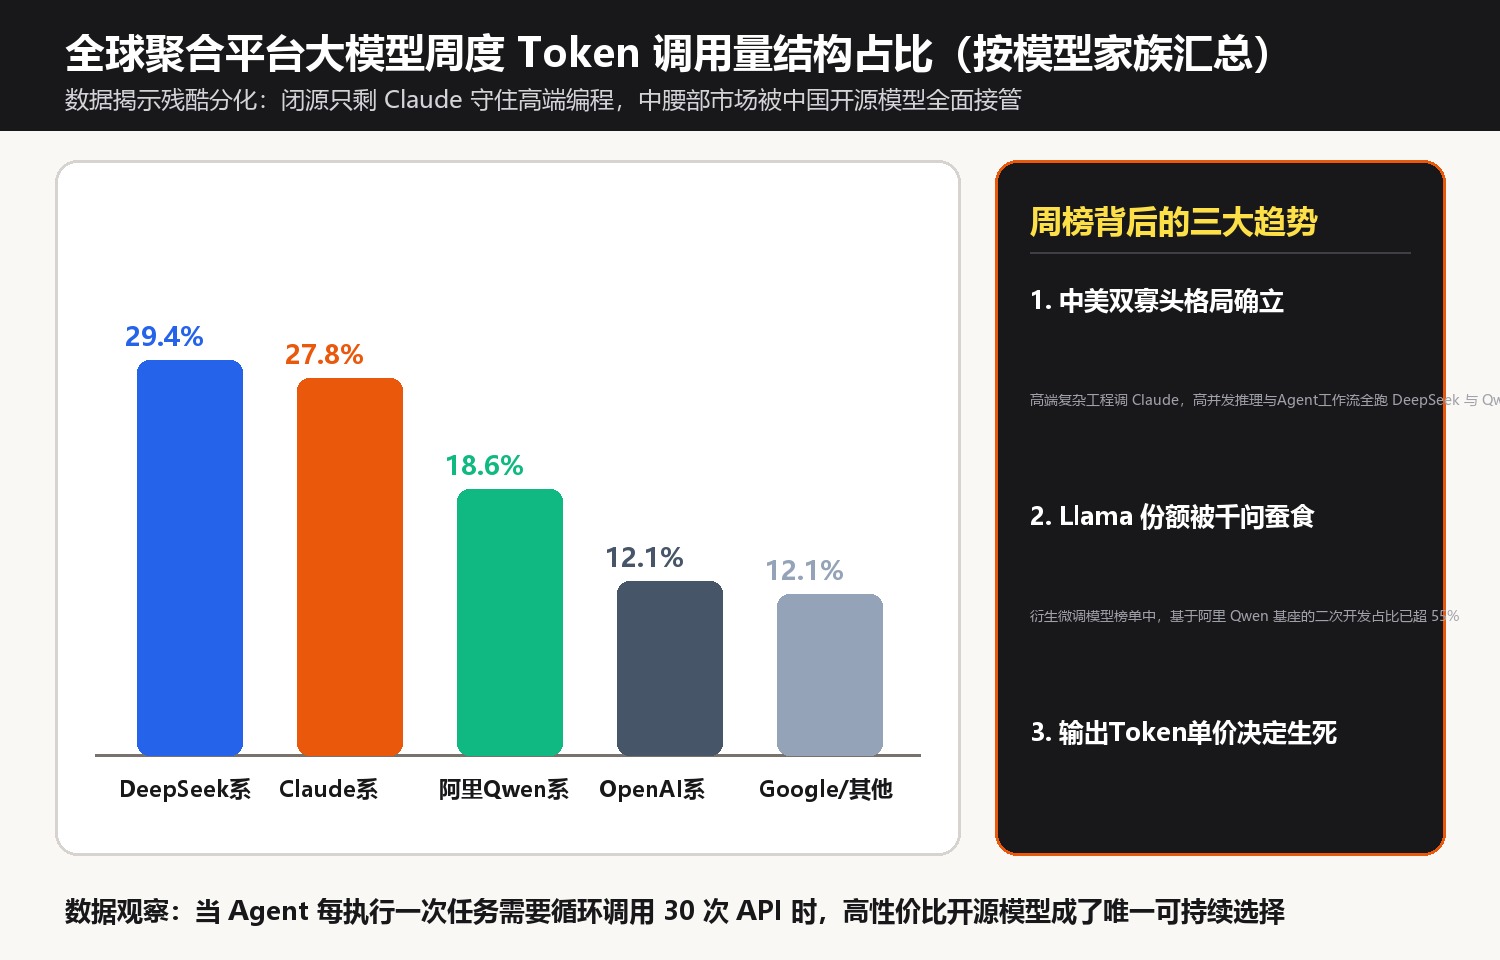
把最新一周全球聚合路由的 Token 消耗量按模型家族拆开,现在的市场格局已经非常清晰地分化为三大阵营:
- 第一阵营:DeepSeek 家族(占比约 29.4%)
- 凭借 DeepSeek-V3 的极致性价比与 R1 的硬核深度推理能力,DeepSeek 在大批量逻辑分析、长文档提取、自动化工作流(Agent)以及数学代码推导场景中稳居全球调用量第一梯队;
- 第二阵营:Anthropic Claude 家族(占比约 27.8%)
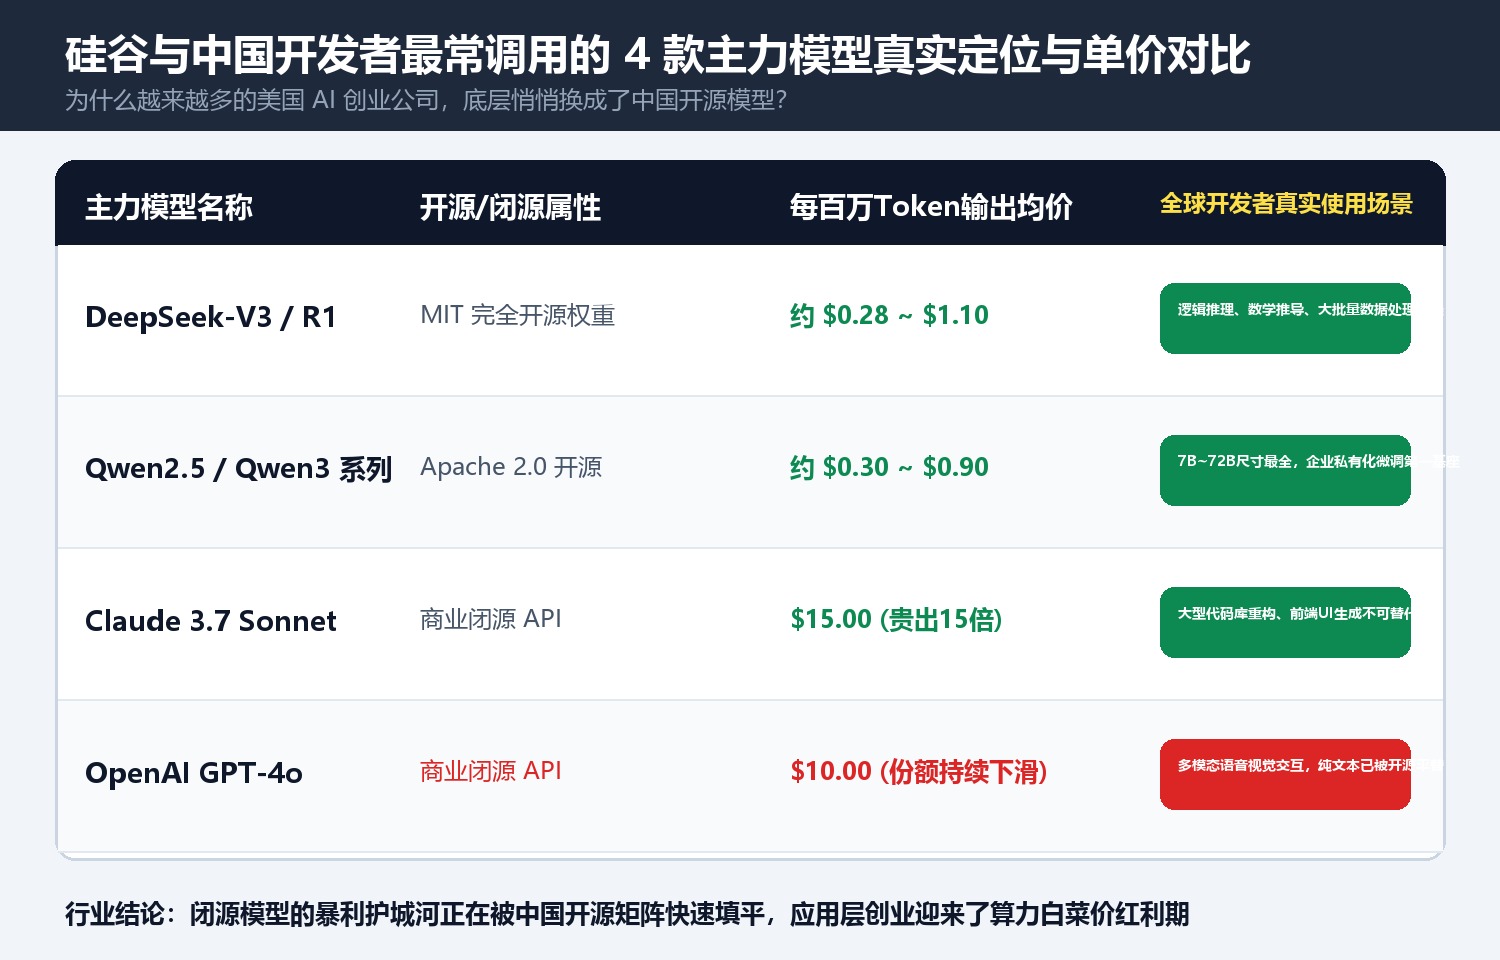
- 作为美国闭源阵营里唯一依然坚挺的印钞机,Claude 3.5 / 3.7 Sonnet 死死守住了「大型软件工程重构」这块高客单价阵地。哪怕它的单价是开源模型的十倍以上,全球程序员在写核心复杂代码时依然甘愿为它掏钱;
- 第三阵营:阿里通义千问 Qwen 家族(占比约 18.6%,开源微调衍生榜第一)
- 千问最可怕的地方在于它的**「全尺寸覆盖率」**。从能在手机和旧笔记本上飞奔的 3B/7B/14B,到极具创造力的
30B-A3B混合专家模型,再到对标顶级闭源的 72B/Max,全球开源社区 HuggingFace 上新发布的微调模型里,超过 55% 都是拿阿里千问当底座改出来的,彻底取代了当年 Meta Llama 的位置。
- 千问最可怕的地方在于它的**「全尺寸覆盖率」**。从能在手机和旧笔记本上飞奔的 3B/7B/14B,到极具创造力的
反观曾经一手遮天的 OpenAI GPT-4o 系列,在第三方开发者路由平台上的纯文本 API 份额已经滑落到了 12.1% 左右——因为比写代码它拼不过 Claude 3.7,比性价比和推理成本它又被 DeepSeek 和千问两面夹击。
二、 为什么美国创业公司也开始排队换用中国开源模型?
在硅谷 Y Combinator 最新孵化的 AI 创业团队里,把底层默认接口从 GPT-4o 切换到 DeepSeek 或自建 Qwen 集群,已经成了公开的省钱秘籍。
驱动这场大迁移的根本原因,不是情怀,而是**「Agent(智能体)时代的算力成本死穴」**。
在两年前的「聊天机器人时代」,用户问一句话,模型答一段话,来回只消耗 1,000 个 Token,哪怕模型贵一点,企业也承担得起。
但到了 2026 年的**「AI 智能体(Agent)与自动化编程时代」**:
- 用户只下达一个指令:「帮我监控这 50 家竞品网站的价格变动,生成对比周报并自动更新进数据库」;
- 为了完成这一个动作,AI 智能体在后台要自己搜索网页、读取 HTML、写 Python 爬虫、自己看报错、自己修代码、最后汇总成表——单次任务在后台自动循环调用 API 高达 30 到 50 次,瞬间烧掉 50 万到 100 万个 Token!
这时候我们来算算账:
- 如果底层全接闭源的 $10~$15 / 百万输出 Token 的美国旗舰模型,用户每跑一次任务,公司就要倒贴 30 到 50 块钱人民币,创业公司不到两个月就会被算力费烧穿破产;
- 而切换到能力达到闭源 95% 水准、但每百万输出仅需 $0.3~$1.0(约合人民币 2 到 7 元) 的 DeepSeek-V3 或 Qwen 系列,同样的智能体任务成本直接暴跌了 85%~90%!
三、 对普通用户与技术团队的 3 个风向标信号
看懂了这份全球 28 万亿 Token 的真实周榜,接下来的选型策略其实一目了然:
- 开源模型已经从「凑合能用的备胎」变成了「生产环境主力」:除了最顶级的跨文件复杂前端/全栈工程还需要 Claude 兜底外,90% 的企业知识库、客服自动化、文案生成与数据分析,直接上国产开源模型就是最优解;
- 微调与私有化部署认准千问(Qwen)底座:如果你的企业因为数据保密要求必须在内网机房自己搭模型,优先选 Qwen 系列的 14B、32B 或 MoE 版本,量化工具链与中文语料底子目前全球最成熟;
- 算力单价还会继续跌:随着中国开源模型把推理成本打到地板价,应用层开发者再也不需要替算力巨头打工,真正比拼行业工作流深度的红利期才刚刚开始。
讨论