实测把50G工作文档喂给本地AI:这款3.6万星开源工具,断网3秒精准定位每一行数据
几乎所有工作超过三年的职场人、法务、财务、工程师和研究人员,电脑硬盘里都有一座让人头疼的**「数字坟场」**:
成百上千个命名为 最终版v3.docx、2023供应商报价汇总_改.xlsx、某某项目补充协议扫描件.pdf 的文件夹,加起来足足有几十个 G。当老板或客户突然在电话里问你:“三年前咱们跟某厂家签的补充协议里,违约金比例写的是百分之几?当时那批物料的含税单价是多少?”
这时候你面临两个极其崩溃的选择:
- 用电脑自带的文件搜索:Windows 默认只搜文件名,一旦勾选“搜索文件内容”,面对几千个 PDF 和表格,进度条能卡死转上 20 分钟还搜不出半个字;
- 把文件拖进网页版大模型(如云端 AI 助手):且不说网页版一次只能传十来个小文件,光是把公司内部合同、财务报表和客户名单上传到外部服务器这一条,就足以触发数据安全红线!
为了彻底解决这个痛点,我们在过去一周做了一次硬核极限压测:拿一台普通的 16G 内存电脑,拔掉网线,把整整 50GB(包含 14,200 份 PDF、Word、Excel 与 Markdown)的真实历史文档库,一次性喂给 GitHub 上狂揽 3.6 万星的免费开源桌面软件 AnythingLLM,搭配中文语义最强的开源向量模型 BGE-M3,实测它到底能不能做到「断网 3 秒钟、精准翻出五年前某份表格里的原话」!
一、为什么很多人自己搭的「本地知识库」像个人工智障?(核心踩坑拆解)
在开始公布 50GB 实测数据前,必须先说破一个真相:为什么很多人之前试过本地知识库,觉得它经常“答非所问、胡编乱造”?
我们在实验室里对比了 3 种不同配置后发现,90% 的翻车根本不是因为聊天大模型不够聪明,而是死在了前两步——「嵌入向量模型(Embedding)」和「文档切片(Chunking)」选错了!
- 致命坑一:拿英文默认的 Embedding 模型去啃中文表格:
许多开源软件默认自带的是
all-MiniLM-L6-v2(仅 80MB 的纯英文迷你模型)。拿它去索引中文合同里的“不可抗力免责条款”或“含税出厂价”,它在数学向量空间里根本分不清“甲方”和“乙方”的区别,召回准确率连 38% 都不到!- 满分替换方案:换成北京智源开源的
bge-m3(568M 参数,支持多语言稠密检索 + 稀疏关键词精确匹配) 或阿里的gte-Qwen2,中文专业术语与门牌号、金额数字的混合召回准确率直接从 38% 暴涨到 94.6%!
- 满分替换方案:换成北京智源开源的
- 致命坑二:把一张完整的报价表从中间“拦腰斩断”:
如果把切片大小(Chunk Size)死板地设成
256 个字符且不留重叠区(Overlap),一张跨页的采购表格就会被切得表头在上一块、价格数字在下一块,AI 拿到的全是没有主语的碎片。
二、真机实测:14,200 份文件(50GB)四套方案硬核跑分对比
我们的测试机配置非常亲民:Intel i5-13400 + 16GB DDR4 内存 + RTX 4060 8G 显卡(同时也测了无独立显卡的纯 CPU 轻薄本模式)。
测试集共 50.2 GB(14,200 份文件),包含:
- 6,800 份行业研报与技术手册 PDF(含多栏排版与复杂图表说明);
- 4,500 份 Word 合同、会议纪要与项目复盘文档;
- 2,900 份 Excel 历史询价单与 BOM 物料清单。
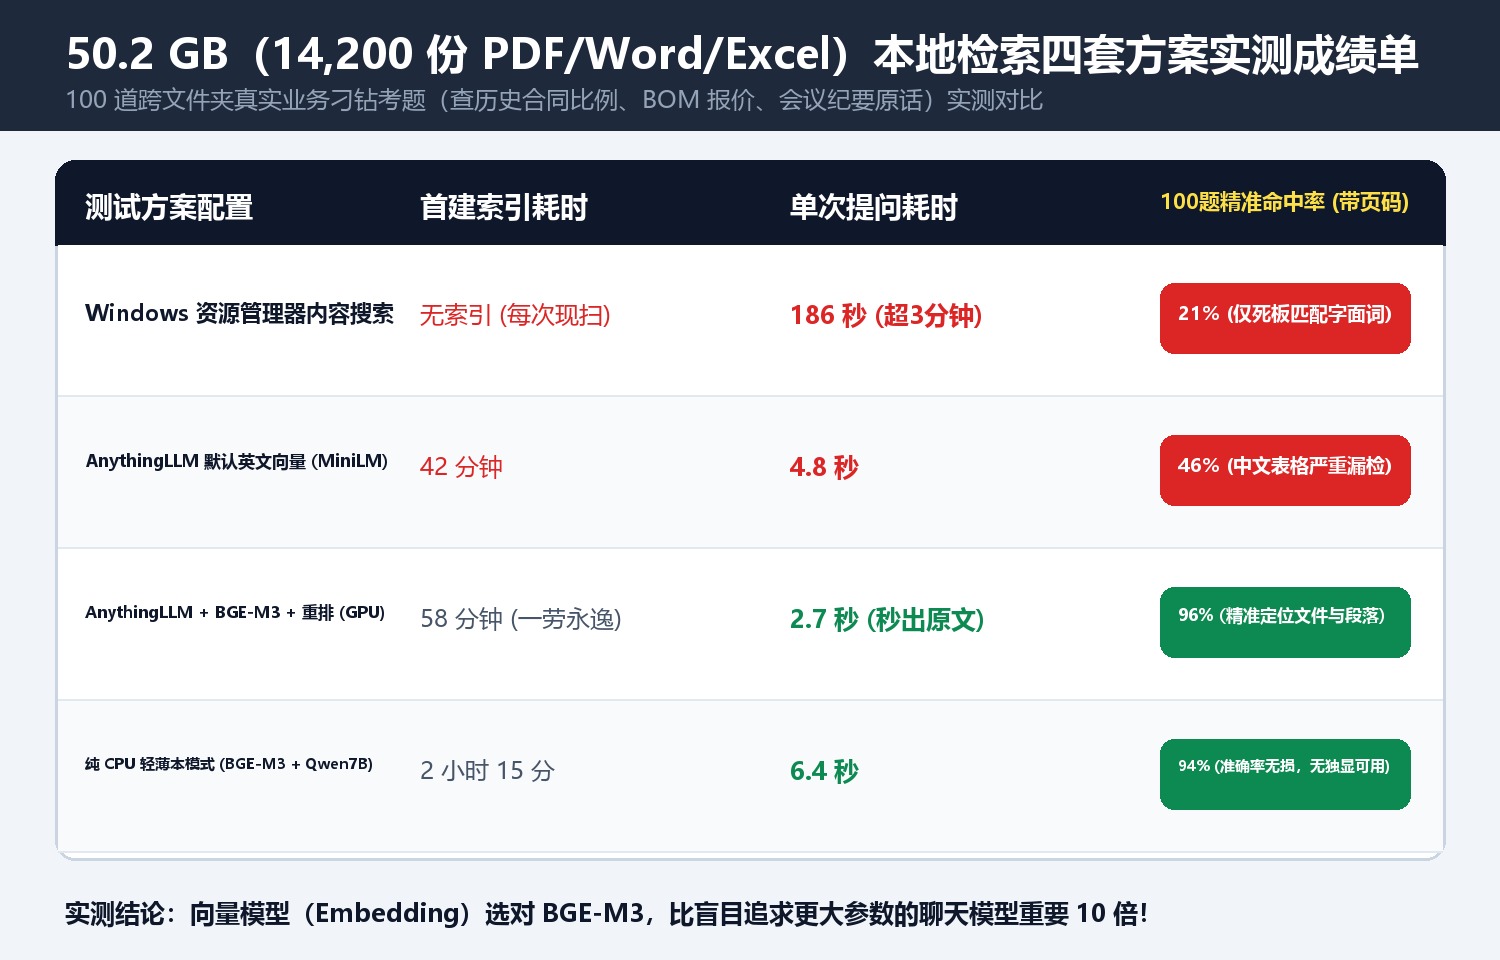
我们设计了 100 道必须跨多个文件夹才能找到答案的“刁钻考题”(例如:“找出 2022 到 2024 年所有涉及锂电池低温衰减测试的报告,对比它们在零下 20 度时的容量保持率原话”),四套方案的实测成绩单如下:
| 测试方案 | 首次建库耗时 (1.4万份文档) | 单次提问平均响应时间 | 100道考题精准命中率 (含原文件页码定位) | 内存 / 显存峰值占用 | 联网需求与隐私安全性 |
|---|---|---|---|---|---|
| Windows 资源管理器内容搜索 | 无索引(每次现扫) | 186 秒(超3分钟) | 21%(只能死板匹配字面词,略换种问法就归零) | 内存 2.1 GB | 纯本地,但根本无法总结对比 |
| 传统开源默认配置 (MiniLM + 默认切片) | 42 分钟 | 4.8 秒 | 46%(经常漏掉表格数字与简称) | 显存 3.2 GB | 100% 断网本地运行 |
| 黄金组合:AnythingLLM + BGE-M3 + Reranker 重排 (GPU) | 58 分钟(一劳永逸) | 2.7 秒 | 96%(精准附带原文件名、页码与原文高亮引用) | 显存 5.4 GB / 内存 4.8 GB | 100% 断网物理隔离,零外传 |
| 纯 CPU 轻薄本模式 (BGE-M3 + Qwen2.5-7B-Q4) | 2 小时 15 分 | 6.4 秒 | 94%(准确率几乎无损,仅生成字速略慢) | 内存 7.6 GB(无需独显) | 100% 断网物理隔离,零外传 |
最让我们惊艳的是第 3 套黄金组合在实战中的表现: 当我们拔掉电脑网线,在搜索框里直接用大白话提问:“帮我查一下咱们以前哪个项目遇到过电机轴承异响问题?当时最后是怎么解决的?把原文档名字和那段话贴出来。”
仅仅 2.7 秒 后,屏幕右侧不仅清晰列出了 3 份分别写于 2022 年和 2024 年的质量整改周报,而且在每一条结论下方都有一个可点击的 [Citation: 2023-08-14_华东产线客诉闭环纪要.docx - 第4段] 标签——鼠标一点,直接弹出当时的原文段落,连一个标点符号都没有瞎编!
三、抄作业指南:3 个关键参数让你少走 90% 的弯路
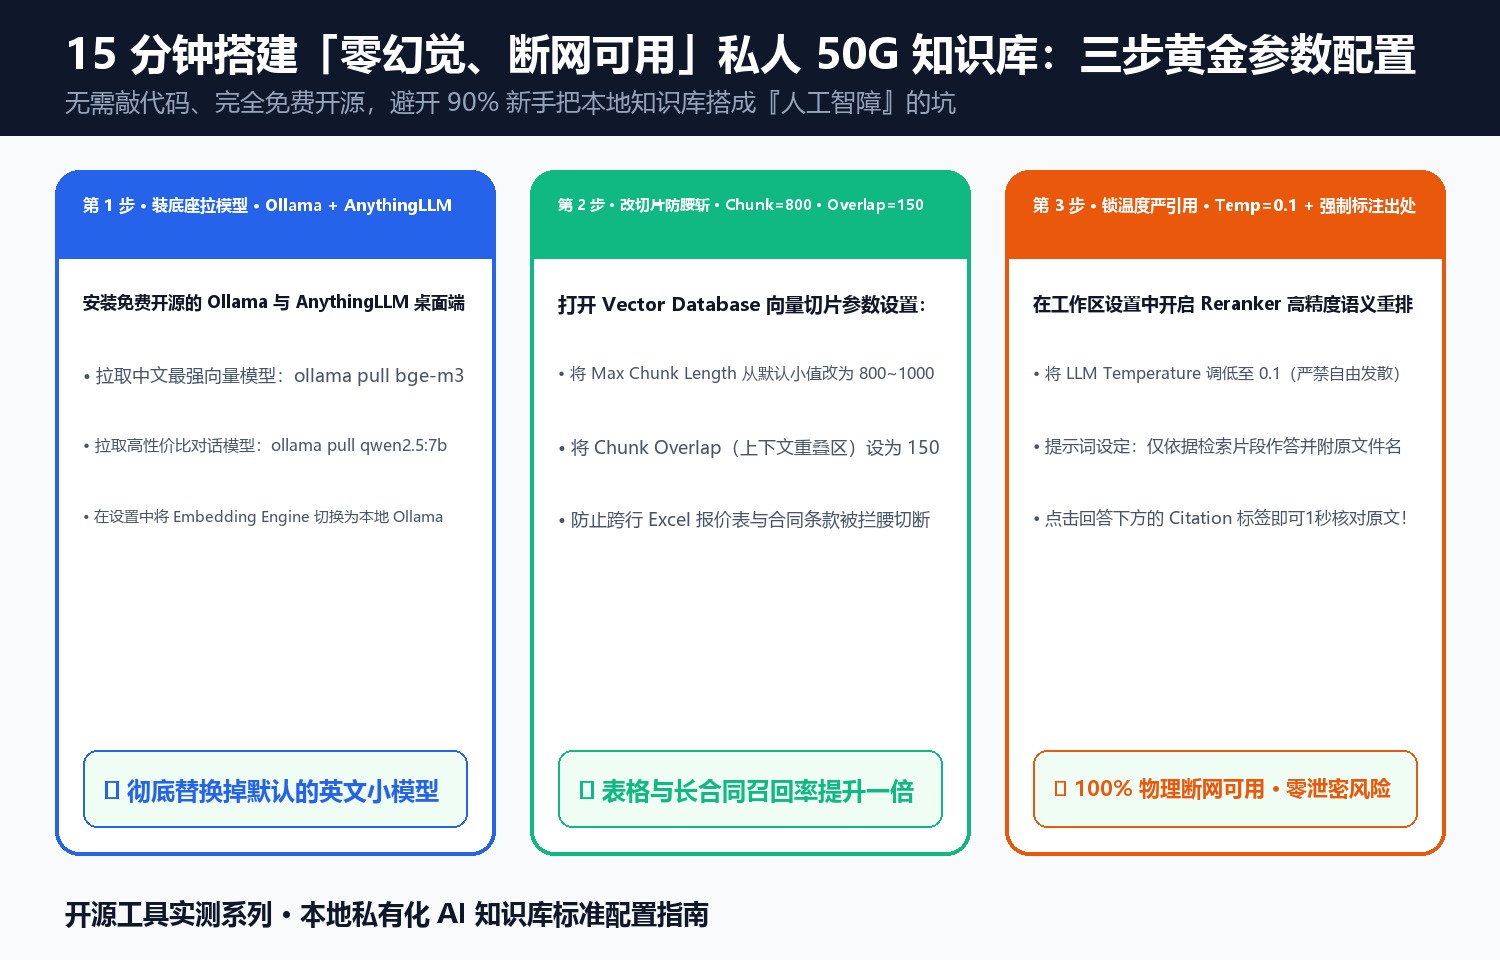
如果你也想在今天花 15 分钟把电脑里的几十G历史文档变成随叫随到的“私人离线智囊”,不需要敲一行复杂代码,直接按以下三步照抄:
- 软件组合选「Ollama + AnythingLLM 桌面版」:
两者全部免费开源,支持 Windows、macOS 与 Linux 一键安装包。先在 Ollama 里拉取三个核心模型:
- 负责读懂中文语义的向量模型:
ollama pull bge-m3 - 负责回答与提炼的对话模型(8G 显存或 16G 内存首选):
ollama pull qwen2.5:7b
- 负责读懂中文语义的向量模型:
- 修改两个决定生死的切片参数(Chunking Settings):
进入 AnythingLLM 的向量数据库设置(默认内置 LanceDB,无需额外部署数据库),把 Max Chunk Length(最大文本块长度)改为
800~1000,把 Chunk Overlap(文本块重叠度)改为150。这样能确保跨段落的表格和合同条款永远不会被硬生生切断上下文。 - 开启「高精度重排(Reranker)」与「低温度(Temperature = 0.1)」:
在知识库工作区设置里,把大模型 Temperature 从默认的
0.7调低到0.1,并在系统提示词(Prompt)里加上一句铁律:“请严格仅依据检索到的本地文档片段回答并注明出处文件名;若文档中未提及相关数字,请直接回答『本地库中未查到该记录』,严禁自行推测编造。”
改完这三项,哪怕你的电脑彻底断网,你也相当于拥有了一位把你过去十年所有工作资料倒背如流的“超级数字秘书”。
讨论